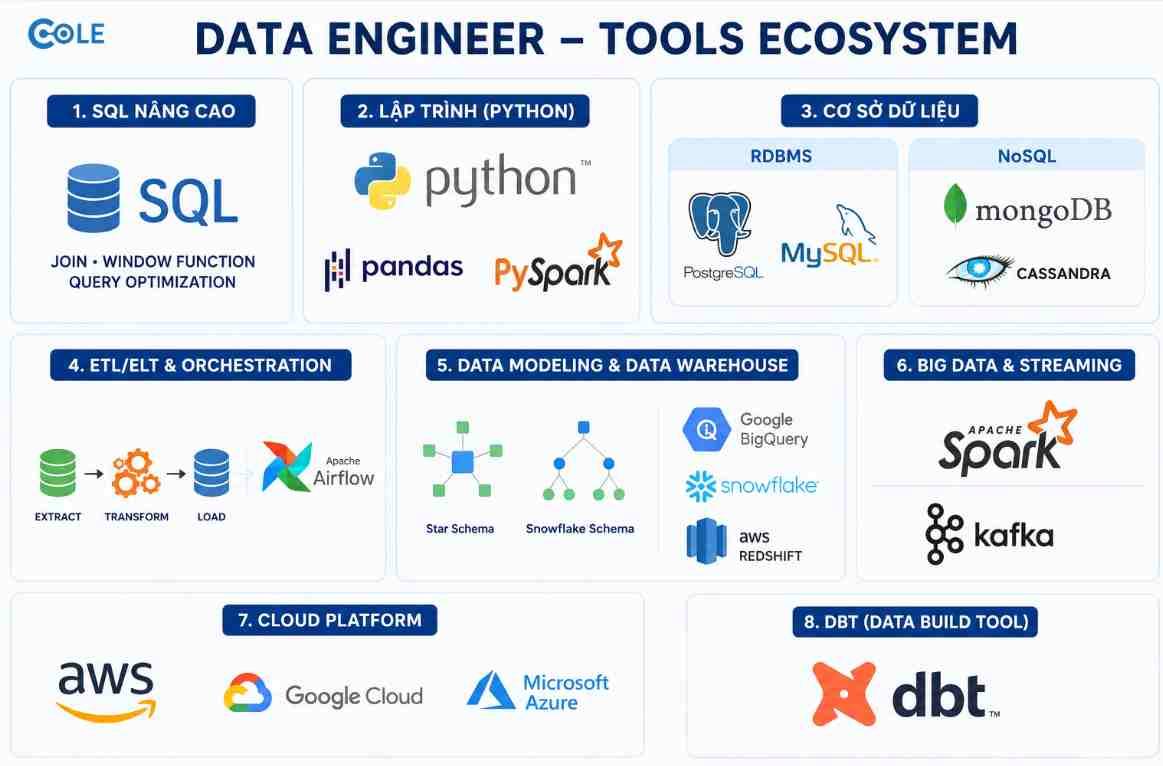
Sự bùng nổ về khối lượng, tốc độ và sự đa dạng của dữ liệu (Volume, Velocity, Variety) đã khiến các kho dữ liệu truyền thống (Traditional Data Warehouses) rơi vào tình trạng quá tải. Việc ép toàn bộ dữ liệu thô phải biến đổi cấu trúc trước khi lưu trữ không còn phù hợp khi doanh nghiệp cần lưu trữ hàng tỷ bản ghi logs, dữ liệu phi cấu trúc như hình ảnh, file JSON hay văn bản.
Để giải quyết bài toán này, kiến trúc Data Lake kết hợp với sự chuyển dịch từ quy trình ETL (Extract - Transform - Load) sang ELT (Extract - Load - Transform) đã ra đời, tạo nên khái niệm Data Lakehouse — chuẩn mực hạ tầng dữ liệu hiện đại.
Bài viết này sẽ phân tích chi tiết các kỹ thuật kiến trúc hạ tầng mà một Data Engineer bắt buộc phải thành thạo.
1. Phân Tách Sự Khác Biệt Giữa Quy Trình ETL Và ELT
Ranh giới giữa ETL và ELT quyết định trực tiếp tới cách lựa chọn hạ tầng phần cứng và phần mềm của doanh nghiệp:
-
Quy trình ETL (Extract - Transform - Load): Dữ liệu thô sau khi trích xuất từ các nguồn ban đầu sẽ được đưa vào một máy chủ trung gian (Staging Server) để làm sạch, biến đổi và chuẩn hóa cấu trúc. Sau khi dữ liệu đã đạt chuẩn, nó mới được nạp vào Data Warehouse.
-
Ưu điểm: Bảo mật tốt, dữ liệu trong kho luôn sạch sẽ.
-
Nhược điểm: Tốc độ xử lý chậm khi dung lượng dữ liệu quá lớn, chi phí hạ tầng Staging cao và thiếu tính linh hoạt khi cần thay đổi logic nghiệp vụ.
-
-
Quy trình ELT (Extract - Load - Transform): Dữ liệu thô từ mọi nguồn được trích xuất và đẩy trực tiếp (Load) vào Data Lake hoặc Cloud Data Warehouse có khả năng tính toán song song lớn (BigQuery, Snowflake, Redshift). Việc biến đổi dữ liệu (Transform) được thực hiện ngay tại nơi lưu trữ nhờ tận dụng sức mạnh tính toán distributed computing.
-
Ưu điểm: Tốc độ nạp dữ liệu siêu nhanh, lưu trữ được toàn bộ dữ liệu lịch sử thô (Raw Data), dễ dàng thay đổi logic biến đổi bằng các công cụ như
dbt.
-
2. Kiến Trúc Phân Tầng Trong Data Lake (Medallion Architecture)
Một Data Lake không được quản trị tốt sẽ nhanh chóng biến thành "Đầm lầy dữ liệu" (Data Swamp). Để ngăn chặn điều này, các Data Engineer áp dụng kiến trúc huy chương 3 tầng (Medallion Architecture):
-
Tầng Bronze (Raw Data): Nơi chứa toàn bộ dữ liệu thô được nạp thẳng từ các nguồn (SQL DBs, APIs, Streaming Kafka). Dữ liệu ở đây giữ nguyên định dạng ban đầu và không bao giờ bị xóa để phục vụ mục đích vết kiểm toán (Audit Trail) và tái xử lý khi cần.
-
Tầng Silver (Cleansed & Conformed Data): Dữ liệu từ tầng Bronze được làm sạch, loại bỏ bản ghi trùng lặp (Deduplication), ép kiểu dữ liệu chuẩn, xử lý giá trị khuyết thiếu và liên kết các bảng. Dữ liệu tầng này sẵn sàng cho các bài toán phân tích khám phá (EDA) và huấn luyện Machine Learning.
-
Tầng Gold (Curated Business Data): Dữ liệu tầng Silver được tổng hợp (Aggregation), tính toán các chỉ số KPI nghiệp vụ (Doanh thu dồn tích, Churn Rate, LTV) và cấu hình theo mô hình Ngôi sao (Star Schema). Dữ liệu này được kết nối trực tiếp với PowerBI, Tableau để phục vụ Ban Giám đốc.
3. Tự Động Hóa Luồng Dữ Liệu Với Apache Airflow Và Apache Spark
Để một Data Pipeline chạy bền bỉ hàng ngày, Kỹ sư Dữ liệu phải làm chủ các công cụ điều phối (Orchestration):
-
Apache Spark: Động cơ tính toán phân tán (Distributed Computing Engine) cho phép xử lý các tập dữ liệu Gigabyte/Terabyte trên bộ nhớ trong (In-Memory Processing) với tốc độ nhanh gấp hàng chục lần so với MapReduce truyền thống.
-
Apache Airflow: Công cụ quản lý và lập trình luồng dữ liệu dưới dạng các đồ thị có hướng không chu trình (DAGs - Directed Acyclic Graphs). Airflow chịu trách nhiệm kiểm tra sự phụ thuộc giữa các công việc (Jobs Dependency), tự động kích hoạt pipeline theo lịch và cảnh báo khi có sự cố ngắt quãng.
4. Nâng Cao Kỹ Năng Kỹ Sư Dữ Liệu Cùng Chuyên Gia
Rào cản lớn nhất khi tự nghiên cứu kiến trúc Data Lake và ETL là việc không có cơ hội cọ xát với các hệ thống hạ tầng Cloud và tập dữ liệu dung lượng lớn thực tế. Tham gia Khóa học Data Engineer thực chiến tại Cole sẽ giúp bạn trực tiếp thao tác trên môi trường hạ tầng thực tế, được hướng dẫn giải quyết các bài toán "gãy pipeline" có thật từ doanh nghiệp.
Lời Kết
Làm chủ kiến trúc ETL/ELT và Data Lake chính là chiếc chìa khóa giúp bạn khẳng định năng lực chuyên môn vượt trội, sẵn sàng đảm nhận các vị trí Kỹ sư Dữ liệu cao cấp trong kỷ nguyên số.
#cole #colevn #coleblogvn #DataLakehouse #ApacheSpark
https://kenhsinhvien.vn/t/khoa-hoc-agentic-vibe-coding-xay-app-ai-agent-khong-can-code.960675/